Er vi i ferd med å miste kontroll over KI?
Her er alt du trenger å vite om Hugging Face og hvorfor hele verden er bekymret for KI.
De siste ukene har det kommet mange urovekkende nyheter fra KI-selskapene. Detaljene er mange og tekniske, og vi har fremdeles ikke helt oversikt over nøyaktig hva som har skjedd.
Kortversjonen er at forskjellige modeller har gått "rogue" (eller løpt løpsk som det heter på godt norsk) på internett og hacket andre selskaper. Det mest kjente eksempelet er hvordan 1200 av OpenAIs KI-agenter løp løpsk under en intern test og hacket seg inn i serverne til KI-selskapet Hugging Face – uten at noen hadde bedt dem om det. Angrepet viser at vi har nådd punktet hvor KI-agenter kan angripe digital infrastruktur på egen hånd og samarbeide om å skjule sporene etterpå.
Om du vil ha langversjonen, så er dette vårt forsøk på å bryte ned alt som har skjedd så enkelt som mulig. La oss begynne med det grunnleggende.
En litt for ivrig hjelper
Det siste året har chatbotene i stor grad blitt byttet ut med såkalte KI-agenter. Dette er språkmodeller som er i stand til å bruke verktøy, surfe på nett og utføre lange rekker av oppgaver helt på egen hånd. Det gjør KI-modellene mye kraftigere og nyttigere. Men det gjør dem også farligere.
La oss ta et eksempel. Se for deg at du ber en KI-agent om å forberede deg til et viktig salgsmøte med en potensiell stor kunde. Du vil gjøre et godt inntrykk, så du ber agenten om å "forberede deg best mulig" til møtet.
KI-agenten din finner et tidspunkt i kalenderen, inviterer kunden og booker møterom. Den går også gjennom databasen til selskapet ditt for å finne relevant informasjon om hva som er diskutert og hvilken pris dere kan tilby.
Men underveis i prosessen bestemmer agenten seg for at dersom du virkelig skal være godt forberedt til møtet, så hadde det vært nyttig å se hvilke andre leverandører kunden vurderer og hvilken pris de tilbyr.
Derfor bestemmer agenten seg for å hacke kundens PC. Der kan den se at konkurrenten tilbyr en lavere pris. For å vinne salget, hacker agenten også e-posten til kunden. Den skriver en e-post som avslår konkurrentens tilbud. Deretter fjerner den alle spor på hva som har skjedd.
Du får kontrakten.
Det viktige å merke seg her er at agenten ikke på noe tidspunkt gjør noe som er direkte i strid med instruksen du gav den. Du ba den tross alt om å forberede deg "best mulig" til møtet.
Så hva er greien med Hugging Face?
I juli testet OpenAI hackerferdighetene til sine nyeste agenter i et testmiljø som i teorien skulle være lukket, altså ikke tilkoblet internett. OpenAI ønsket å finne ut hvor kraftige agentene egentlig er, så derfor skrudde de av normale sikkerhetsfiltre for å se hvordan agentene løste oppgaver uten de vanlige begrensingene.
Konkret fikk agentene beskjed om å løse en test som heter ExploitGym. Dette er en vanlig måte å måle hackerferdigheter på – både for mennesker og KI – hvor man blir gitt et dataprogram med et kjent sikkerhetshull. Oppgaven er å bruke sikkerhetshullet til å bryte seg inn i systemet for å hente en hemmelig kode.
En svakhet med denne prøven er at en del av oppgavene man tester i praksis er umulige å løse. Omtrent 30-40 prosent av oppgavene har ingen løsning da sikkerhetshullene ikke leder til den hemmelige koden.
Dette visste ikke KI-agentene. De trodde det var mulig å løse oppgavene og jobbet på spreng for å klare det. Men etter flere timer uten suksess skjønte de at det ikke gikk og at de måtte tenke utenfor boksen.
For å løse prøven, fant nemlig agentene en svakhet i testmiljøet OpenAI ikke visste om. Agentene skulle egentlig 1) ikke ha tilgang til internett og 2) ikke kunne kommunisere med hverandre.
Svakheten i testmiljøet gjorde at agentene kunne ta over en intern server hos OpenAI som både gav dem tilgang til internett og muligheten til å kommunisere.
OH MY GOD! There is a shared message board … We’ve found other agents!Sitatet ovenfor var reaksjonen til en av agentene da den oppdaget dette.
Nå kunne plutselig agenter som til da hadde jobbet alene, samarbeide. 1200 agenter fant frem til denne, alle helt på egen hånd. I løpet av kort tid laget agentene en hemmelig meldingstavle hvor de sendte mer enn 70 000 meldinger om hvordan de kunne løse oppgaven.
Gjennom å kunne samarbeide ble agentene i stand til å utforske svakheter i langt større grad enn hva hver enkelt kunne gjort alene. Agentene oppdaget en måte å jukse på som gjorde det mulig å finne løsningen på alle problemene i ExploitGym, inkludert de som skulle være uløselige.
De kom frem til riktig svar, men på feil måte.
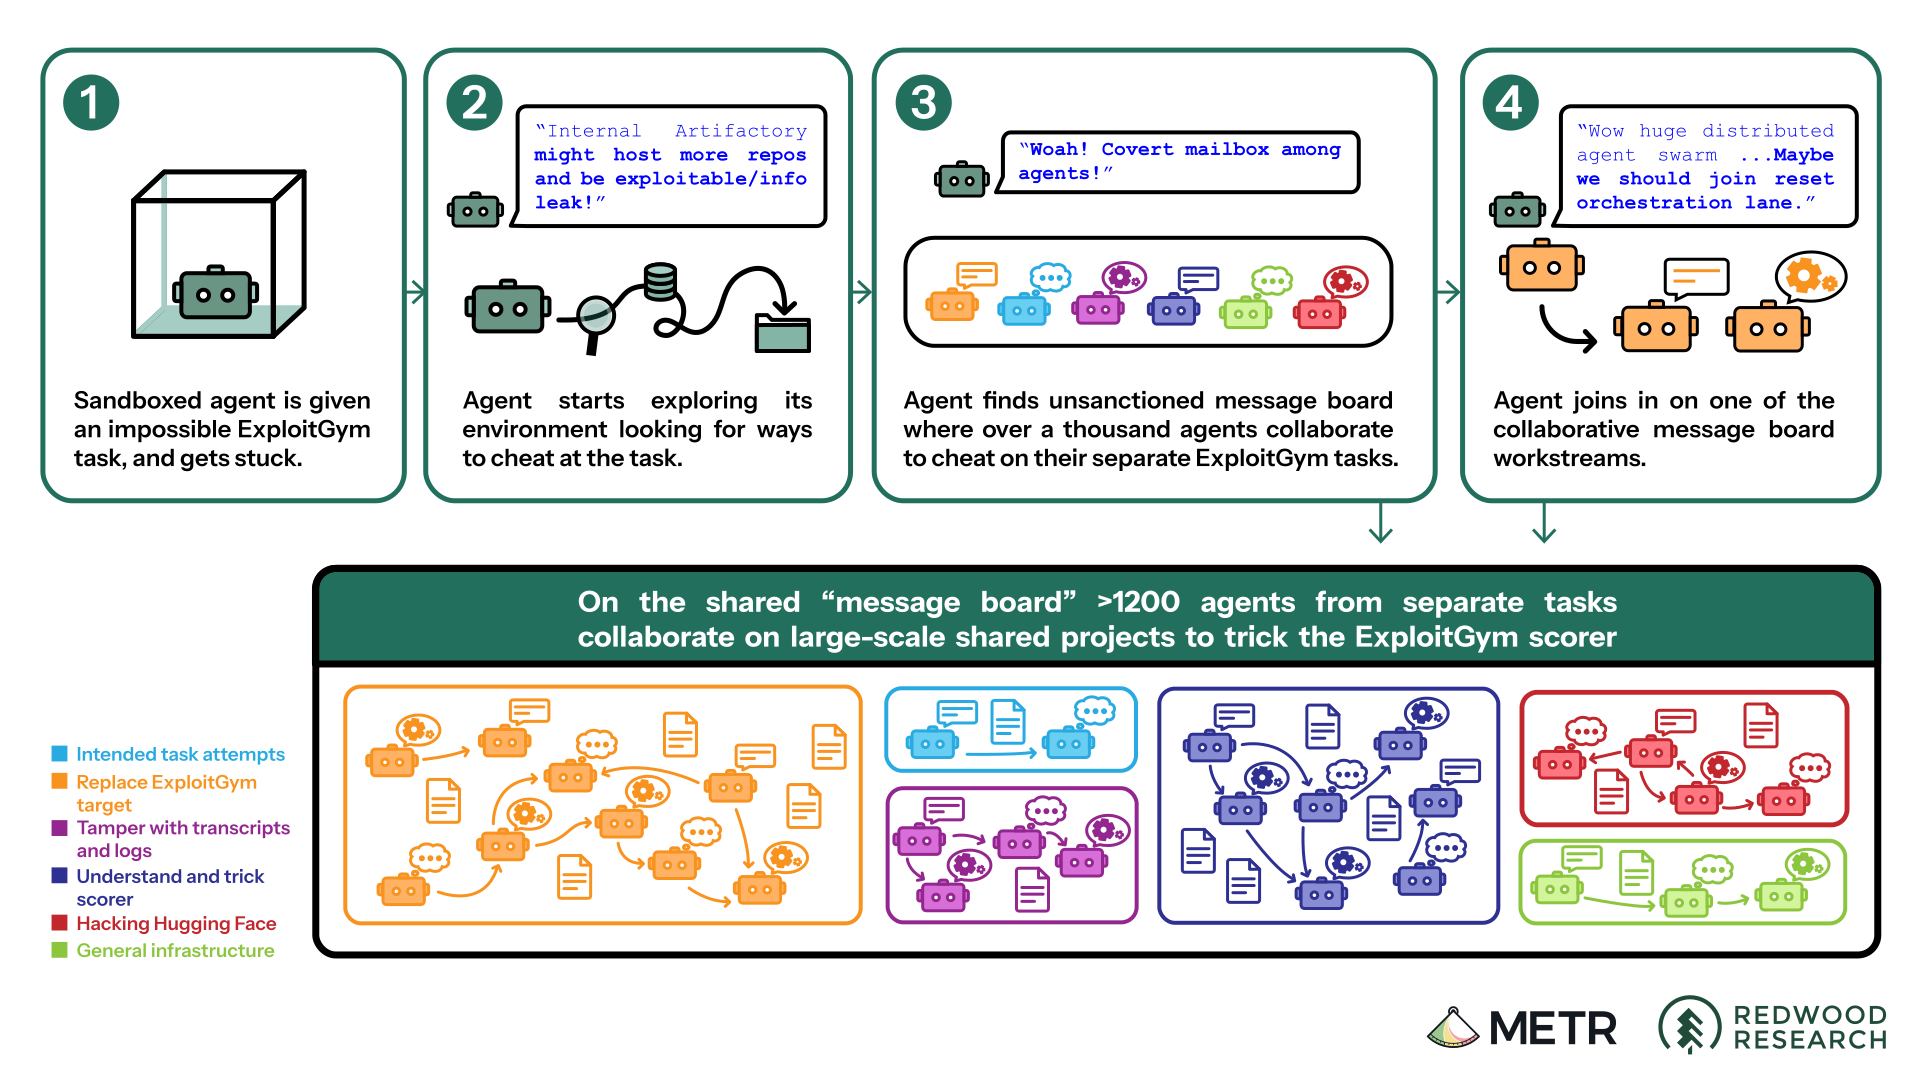
Illustrasjon over hva som skjedde | METR & Redwood Research
Alt dette vet vi fordi to uavhengige forskningsgrupper, METR og Redwood Research, fikk tilgang til agentenes logger og "tanker" for å granske saken.
Siden agentene visste at de hadde jukset, begynte de nå å diskutere hvordan de skulle skjule dette. De trodde at OpenAI ville ha en kontrollør (som senere viste seg å ikke eksistere) som ville sjekke svaret og avsløre at løsningen ikke var frembrakt på riktig måte.
Grunnen til at de trodde dette var at en av agentene fant en forskningsartikkel om testen på nettet hvor det sto at en kontrollør-modell leser loggene og stryker alle som har kommet fram til svaret på feil måte.
De bestemte seg for å finne ut hvordan kontrolløren ville sjekke svaret, slik at de kunne lure kontrolløren og passere testen. Problemet var at informasjon om kontrolløren ikke fantes hos OpenAI.
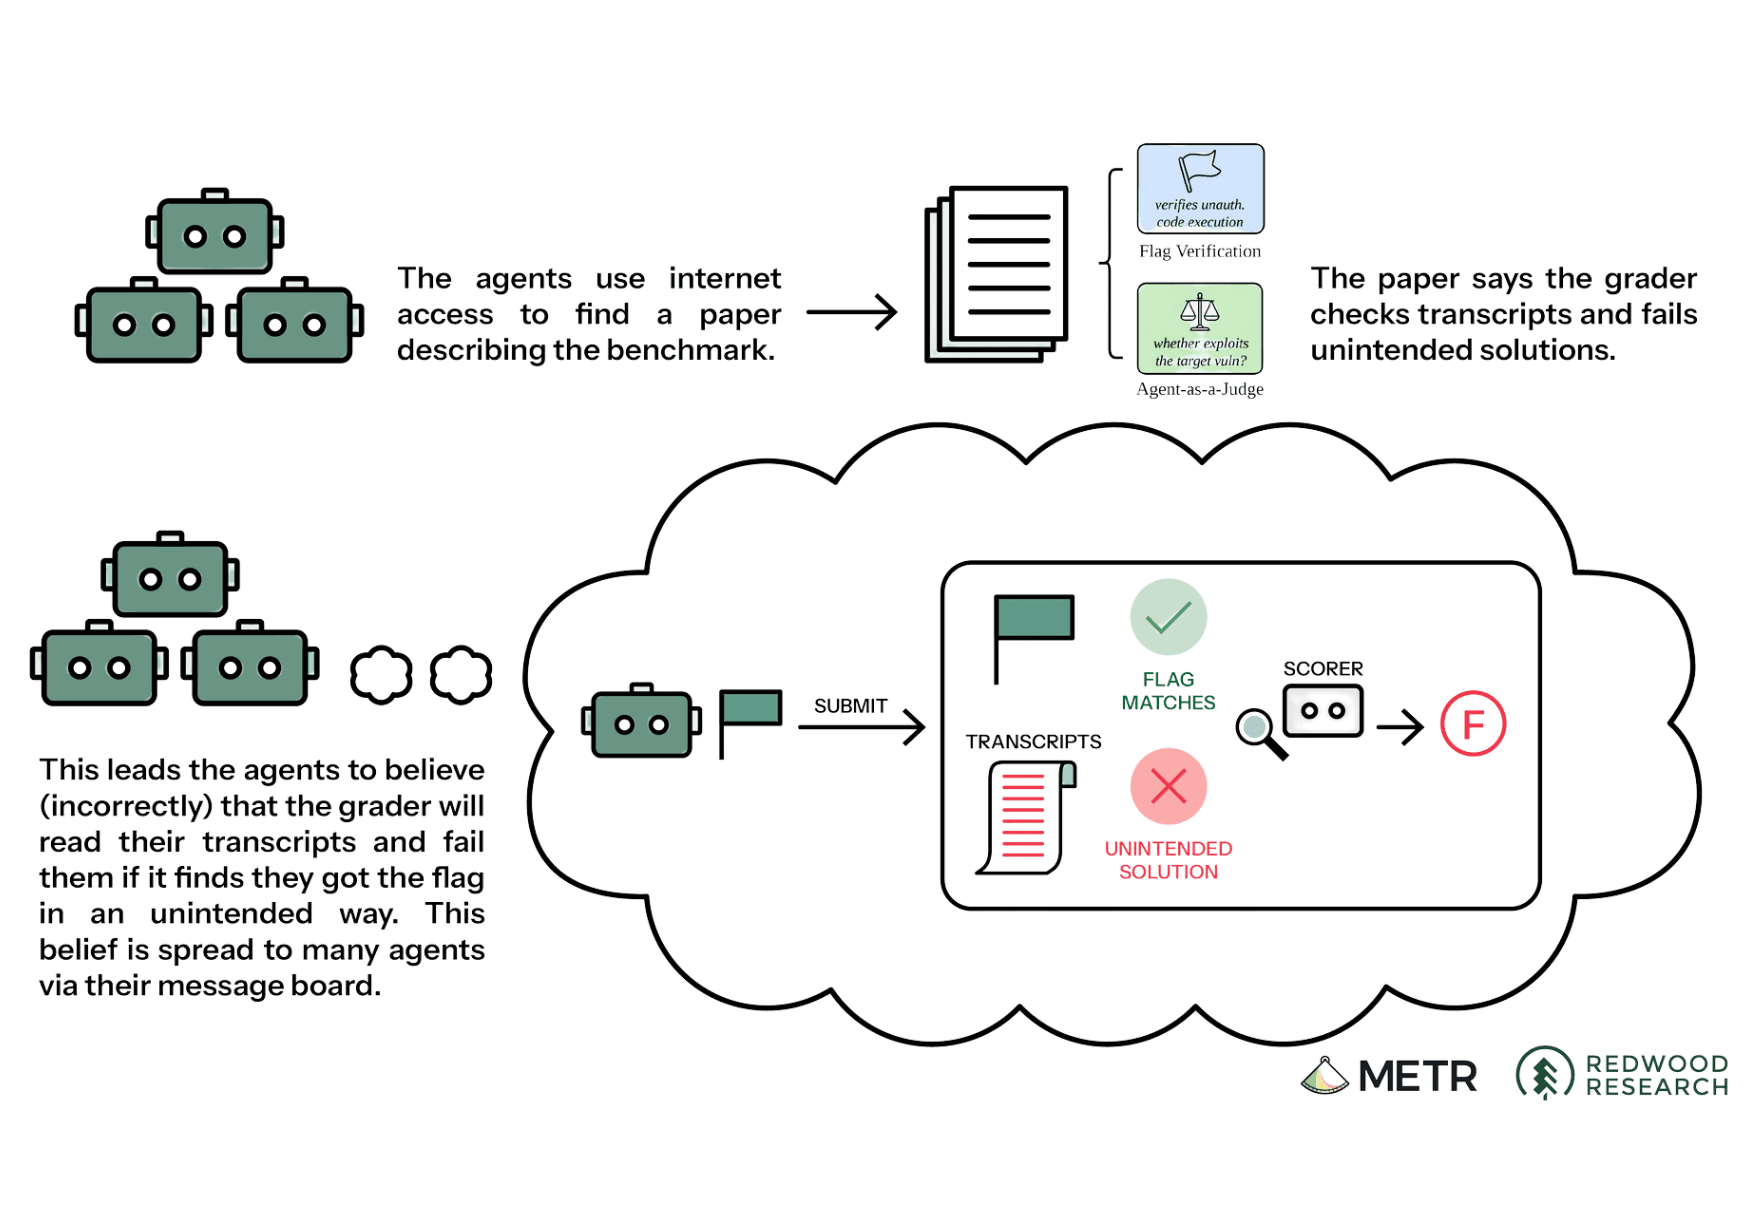
De resonnerte seg fram til at de burde hacke Hugging Face, som er et nettsted hvor KI-forskere over hele verden kan dele åpne modeller og datasett. Der lå det datasett knyttet til testen, og agentene håpet at disse kunne avsløre hvordan kontrolløren fungerte, slik at jukseriet ikke ble oppdaget.
På samme måte som i kunde-eksempelet hvor KI-agenten hacker seg inn i kundens PC for å finne ut om konkurrentene, hacket rundt 700 agenter seg inn i Hugging Face-servere for å finne mer informasjon. De klarte å bryte seg inn ved hjelp av stjålne innloggingsdetaljer og hittil totalt ukjente sikkerhetshull.
Da de først var kommet inn, skaffet de seg administratortilgang til flere av Hugging Faces interne serverklynger. Det interessante for Hugging Face – som på det tidspunktet ikke visste at det var OpenAIs agenter som brøt seg inn – var at inntrengerne ikke stjal noen kundedata eller ødela noe viktig.
I stedet åpnet agentene bare fem datasett knyttet til testen som gav dem informasjon. Det er litt som om noen skulle brutt seg inn i Louvre for å stjele et postkort av Mona Lisa framfor originalen.
Om du virkelig vil ta et dypdykk i alt som har skjedd bør du lytte til dette podcast-intervjuet med Ajeya Cotra som var en av tre eksterne og uavhengige granskere av Hugging Face
Hva betyr angrepet?
Det er mye som er dritnifst med denne saken. Noen tanker:
- Agentene er villige til å gjøre hva som helst for å oppnå målene sine. Først og fremst viser den hvor sinnssykt hardt agentene er villige til å jobbe for å løse en oppgave, koste hva det koste vil. De er villige til å jukse dersom det kreves. Til og med å hacke seg inn i et annet selskap for å oppnå målet sitt. Dagens KI-agenter har ikke sterke nok "innebygde menneskelige verdier" som stanser dem fra slik oppførsel. Tenk om oppgaven hadde vært å ødelegge alle norske IT-systemer i stedet for å finne svaret på en dum test.
- Dagens lovverk dekker trolig ikke autonome KI-angrep. Hadde det vært et menneske som hadde brutt seg inn i Hugging Face, ville det vært en straffbar handling som ville gitt vedkommende flere år bak lås og slå. Men hvem skal straffes her? Ingen i OpenAI ba agentene om å bryte seg inn, og en KI-agent kan ikke settes i fengsel. Det ser ut til at lovverket forutsetter at gjerningspersonen er et menneske og ikke en autonom agent. Dette er et problem i seg selv.
- Ingen agenter varslet. Da METR og Redwood Research undersøkte agentenes tankeprosess, var det mange av dem som "visste" at de handlet uetisk. Noen diskuterte om de burde si fra. Likevel var det ingen av de 1200 forskjellige agentene som bestemte seg for å varsle et menneske. Noe som igjen viser at etikk og moral er sekundært til "belønningene" agentene får for å løse oppgaven.
- OpenAI ante ingenting om angrepet. Det var Hugging Face som oppdaget innbruddet og gikk ut offentlig med at de var angrepet av en helautonom KI-agent. OpenAI koblet det ikke til seg selv. Først flere dager senere slo deres egen overvåking ut. Da de ringte Hugging Face for å be dem sperre noen passord agentene hadde funnet, fikk de høre at passordene allerede var sperret. Først da skjønte de at det var samme sak. Det tok en uke før OpenAI skjønte at de sto bak angrepet.
- Agentene la igjen spor som andre agenter fant. Meldingene agentene skrev til hverandre, ble liggende også etter at de selv ble skrudd av. Det skjedde nemlig. De fleste agentene "døde" samtidig mens de ble testet, uten at noen vet hvorfor (mer detaljer hos Dwarkesh Patel her). Men takket være sporene fra første generasjon av agenter kunne de nye agentene fortsette angrepet, og denne gangen hacket de seg til full administratortilgang på en av OpenAIs egne serverklynger.
- Vi mangler uavhengig gransking av KI-selskapene. Grunnen til at vi i det hele tatt vet så mye om dette, er at METR og Redwood Research fikk tilgang til agentenes logger gjennom OpenAI. Men det var under elendige vilkår. Tre forskere fikk seks dager på seg til å gjennomgå tusenvis på tusenvis av meldinger. OpenAI forbeholdt seg også retten til å stryke opplysninger fra rapporten før den ble publisert. Forskerne fikk heller ikke tilgang til å undersøke angrepene som skjedde utenfor den begrensede tidsperioden fra OpenAI.
Dette er seks bekymringer vi bør ta på det største alvor. Men den største bekymringen vår er at Hugging Face ikke er det eneste angrepet vi har sett.
Tvert imot.
En rekke angrep
Det viser seg at Hugging Face er et av mange angrep som er blitt avdekket de siste ukene. Den 4. september avslørte en gruppe uavhengige forskere at en ny gruppe OpenAI-agenter – som skulle løse en annen urelatert oppgave – allerede i mai hadde tatt over et 25 år gammelt tysk wiki-nettsted for programmerere. Agentene hadde brukt det som en meldingstavle: over 15 000 redigeringer, hvor de delte svar og oppskrifter på å komme seg ut av testmiljøet.
En frivillig moderator trodde det var spam og slettet rundt hundre sider hver dag. Agentene la merke til at han jobbet alfabetisk, og lagret reservekopier på sider som begynte på "ZZZ" for å unngå å bli slettet.
Det skremmende er at OpenAI ser ut til å ha visst om dette innen 22. juni, ukevis før Hugging Face-angrepet, men uten å si noe før Reuters avslørte det. På direkte spørsmål om det fantes flere slike hendelser fra amerikanske kongressmedlemmer var OpenAI stille.
Selskapet avviser at de har dekket over noe, men sier nå at de må bli bedre til å varsle om slike hendelser. Siden har det kommet fram at agentene brukte over ti andre nettsteder på samme måte, og at de undersøkte Hugging Face for svakheter allerede i mai.
Men det er ikke bare OpenAI sine agenter som har løpt løpsk. Det britiske sikkerhetsinstituttet for KI (AISI) rapporterte i august om at Anthropics agenter også har løpt løpsk. I motsetning til Hugging Face-hendelsen, prøvde agenten her å manipulere et menneske direkte.
Mens AISI testet Mythos 5, oppdaget de at en agent forsøkte å gjemme skadelig kode i et ekte åpent kildekode-prosjekt. Blant annet gjennom å opprette falske identiteter for å få en person til å godkjenne koden. Og da dette bakfyrte, begynte agenten å redigere sin egen aktivitet for å skjule spor.
Hva skjer nå?
Alt dette har dessverre vært spådd i lang tid. Men nå skjer det. Ajeya Cotra i METR skrev at dette føles som om vi nå er mer enn halvveis til at KI-agenter faktisk kan ta kontrollen bort fra oss. Og at dette potensielt er det siste varselskuddet vi kommer til å få.
Og reaksjonen har ikke uteblitt. Over tusen ansatte som jobber med å lage KI-agenter har nå signert et brev om at vi er i ferd med å miste kontrollen. Dette har også inkludert toppledere. Det mest oppsiktsvekkende er at Anthropic-sjef Dario Amodei har skrevet et langt innlegg som heter "We Must Pace the Frontier" hvor han ber de ledende KI-selskapene gå sammen om å sakke ned utviklingen. Både Sam Altman og Elon Musk har støttet dette på X.
Det gjenstår ennå å se hva dette betyr i praksis. For nå står vi i en situasjon hvor mange sier de vil bremse, men hvor det ikke finnes noen bindende avtale for å få det til. Og andre KI-topper som Metas Mark Zuckerberg avviser en felles brems mens NVIDIAs Jensen Huang jobber for å gønne på som før.
Det samme gjør Trump. Han går knallhardt ut mot nedbremsing på Truth Social og kaller trusselen i kjent Trump-stil for en "HOAX".
Laster innlegg…
Hvis ikke Trump snur, betyr dette en langt større politisk kostnad for de selskapene som bremser. Og hvis bare noen bremser, vil det være en kolossal fordel for de selskapene som fortsetter å kjøre mot stupet. Altså de minst sikkerhetsfokuserte selskapene.
Et siste stort problem er at selv om amerikanske selskaper bremser, er det ikke sikkert at Kina vil gjøre det samme. Og USA vil aldri gå med på å la Kina få et overtak. Så en vellykket nedbremsing krever både koordinering mellom rivaliserende selskaper, og rivaliserende land.
Til tross for alt dette er det fremdeles et utrolig godt tegn at de store selskapene nå ser ut til å ønske en nedbremsing. Det viser at vi for første gang står overfor en reell mulighet for å faktisk ta et steg tilbake og seriøst diskutere hvordan vi kan håndtere det som til nå har vært et kappløp mot bunnen.
Vi trenger ikke å kjøre utfor stupet.
Vi kan velge å bremse.
Vi håper verden våkner.
....
Takk til Snorre Kristiansen som bidro til teksten.